[線形代数] 条件数はなぜ数値計算の難しさを表すのか
行列の条件数が、連立一次方程式の解の精度にどう関わるかを説明する。行列を固定して右辺だけに誤差を加え、相対誤差の増幅率の上限を導く。特異値と楕円の形、誤差の方向による増幅率の違い、残差が小さくても解が不正確になる例をPythonで確認し、条件数と計算方法の安定性の違いを整理する。
線形代数・確率・統計を定義と計算の両面から整理します。
行列の条件数が、連立一次方程式の解の精度にどう関わるかを説明する。行列を固定して右辺だけに誤差を加え、相対誤差の増幅率の上限を導く。特異値と楕円の形、誤差の方向による増幅率の違い、残差が小さくても解が不正確になる例をPythonで確認し、条件数と計算方法の安定性の違いを整理する。
Hilbert行列は逆行列を持つが、入力の小さな誤差で連立一次方程式の解が大きく変わることがある。積分で正則性を示し、条件数から誤差の増幅を説明する。Pythonで残差と解の誤差を比べ、右辺や計算精度を変えた結果から、入力を高精度で作り直す場合と丸めた入力を使う場合の違いを確認する。
Newton法が単純根の近くで少なくとも2次収束する理由を接線による更新式とTaylor展開から説明する。平方根の計算をPythonで実装し、誤差の減り方と収束次数を確かめる。重根で収束が遅くなる例や、初期値によって収束しない例を扱い、丸め誤差による精度の限界をグラフで確認する。
Newton法が収束しない3つの例をPythonで再現する。反復値が0と1を往復する場合、絶対値が2倍ずつ増え続ける場合、導関数が0で更新できない場合を、更新式とグラフで説明する。初期値を変えた結果やBrent法の結果と比較し、残差や終了理由も調べて、計算が収束したかを確かめる。
広告や値下げなどマーケティングミックスを考慮した新製品普及予測モデル、一般化バスモデル(GBM)の理論とPythonシミュレーションを解説。
新製品普及を予測するバスモデルと感染症拡大を予測するSIRモデルを比較し、数理的な共通点と違いを解説する記事。
新製品の普及プロセスを数理的にモデル化するバスモデル(Bass Diffusion Model)の理論とPythonシミュレーションを解説する記事。
稀に起こる極端な現象を扱う極値統計学の基礎、ガンベル分布の定義と性質を、Pythonでのパラメータ推定や可視化とともに解説する記事。
推薦システムで用いられる評価行列・隣接行列・次数行列・ラプラシアン行列の定義を、PythonのNetworkxで計算しながら解説する記事。
mlxtendを用いたApriori・FP-Growthアルゴリズムによるアソシエーション分析を解説し、サポート・信頼度・リフトの指標をKaggleの購買データで計算する方法を紹介します。
顧客のRecency・Frequency・Monetaryを分析するRFM分析の考え方を解説し、Faker・ポアソン分布・ガンマ分布で作成したダミー購買データをsqlite3でSQLiteに格納して分析します。

コレスキー分解・LU分解・QR分解・スペクトル分解・特異値分解という5つの行列分解を理論とPython実装例つきで解説する。
特異値分解(SVD)と主成分分析(PCA)の数学的な定義を整理し、numpyによる計算例と推薦システムにおける評価行列の低ランク近似への応用を解説する。
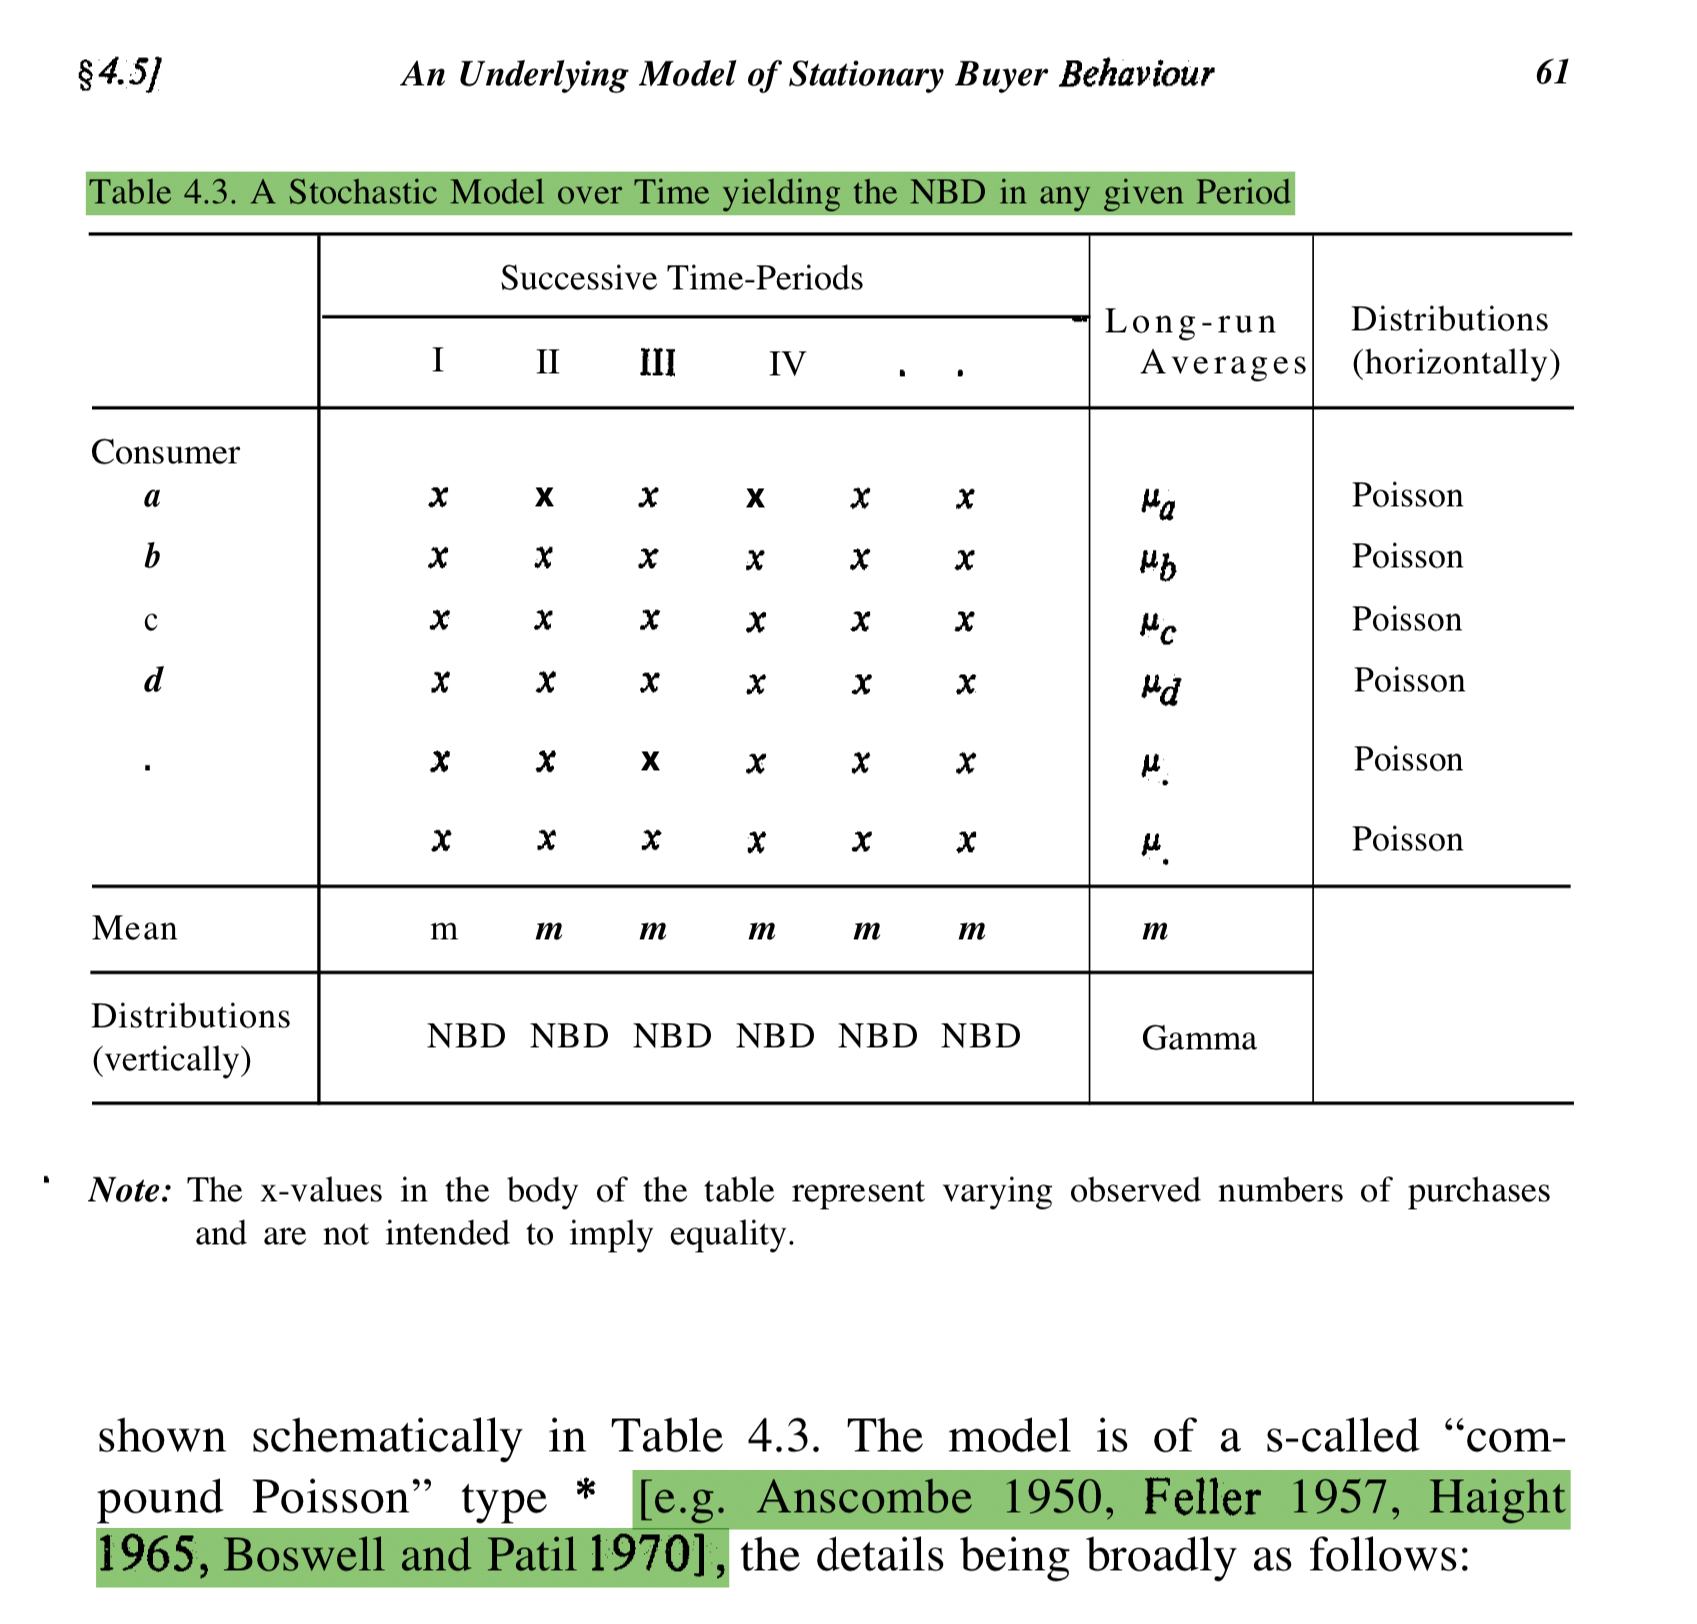
Ehrenberg氏の論文「Repeat-Buying」を紹介し、購入回数をガンマ分布で表現する根拠や負の二項分布が導かれる過程を解説する。
「確率思考の戦略論」の巻末解説にある6つの分析ツールを紹介し、ガンマ・ポアソン・リーセンシーモデルの計算をscipyのcurve_fitで実装する。
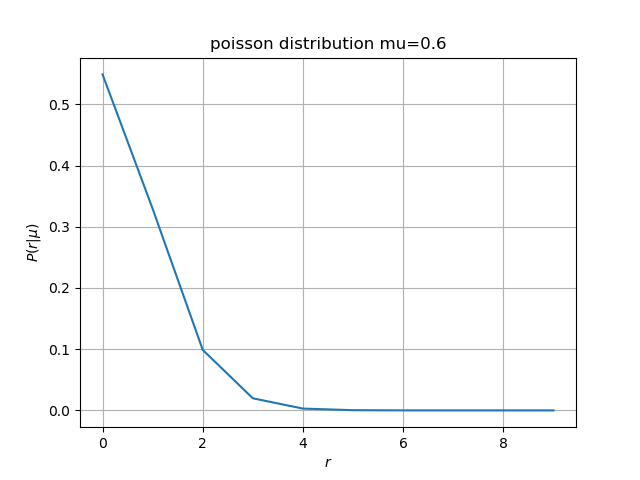
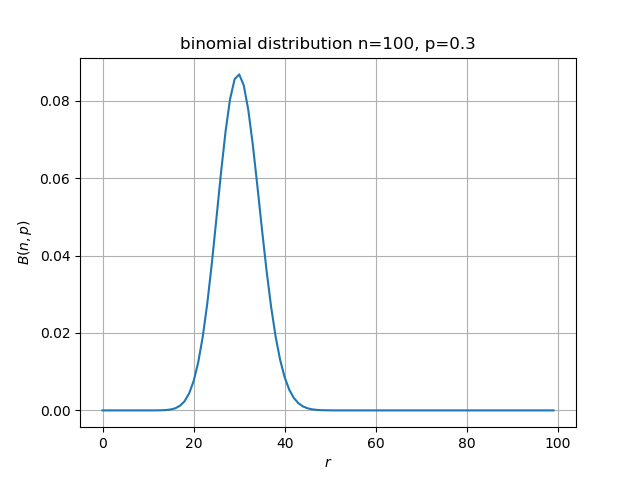
「確率思考の戦略論」の内容に沿い、二項分布やポアソン分布など消費者プリファレンスを表す確率分布の意味をPythonのコード例とともに解説する。